Categoria: Intelligenza Artificiale & Architettura Software
Oltre i chatbot: architetture multi-agente nel software enterprise
Portare l'AI nei processi aziendali significa trasformare un modello probabilistico in un componente affidabile: ruoli separati, output validati, azioni reversibili e tutto tracciato.
Pubblicato il · 4 min di lettura
Argomenti: #Agentic AI #LLM Engineering #Enterprise Systems #API Integration

Per anni "integrare l'AI" in un gestionale ha voluto dire aggiungere una chat in un angolo dell'interfaccia. Utile per rispondere a qualche domanda, poco utile per il lavoro vero. Oggi la domanda che ci fanno le aziende è diversa: possiamo affidare a un modello linguistico un processo, e non solo una conversazione?
La risposta è sì, a una condizione: smettere di trattare il modello come un oracolo e cominciare a trattarlo come un componente di sistema. Un componente con un contratto d'interfaccia, dei permessi, dei test e dei log.
Il problema: un modello non è deterministico
Un LLM, per sua natura, è probabilistico. La stessa richiesta può produrre risposte leggermente diverse, e ogni tanto una risposta sbagliata espressa con grande sicurezza. In una chat è un fastidio; in un flusso che registra una fattura o aggiorna un ordine è un rischio.
L'obiettivo quindi non è rendere il modello deterministico, cosa che non è possibile, ma costruirgli intorno un'architettura che renda il sistema controllabile: ogni output viene validato, ogni azione è limitata e reversibile, ogni passaggio è registrato.
Ruoli separati, non un unico agente tuttofare
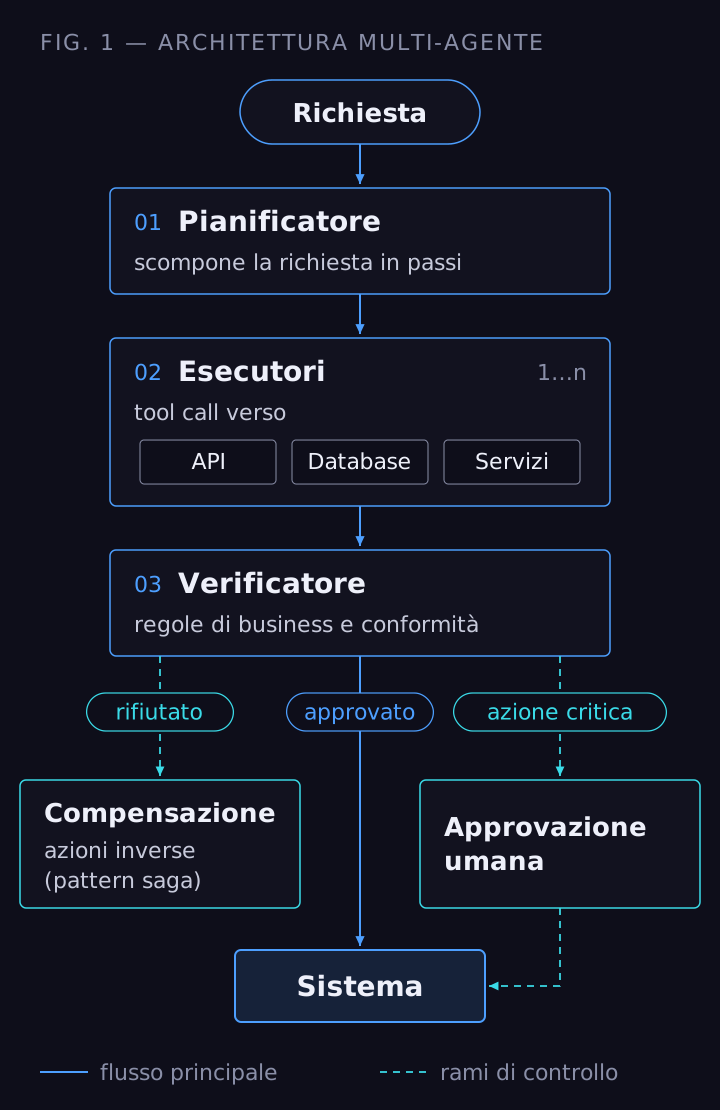
Il primo cambio di prospettiva è abbandonare l'idea di un singolo agente che fa tutto. Nelle architetture che funzionano in produzione i compiti sono divisi:
- un agente di pianificazione scompone la richiesta in passi;
- uno o più agenti di esecuzione chiamano API, database e servizi;
- un verificatore controlla che il risultato rispetti regole di business e vincoli di conformità prima che diventi definitivo.
Separare i ruoli ha un vantaggio pratico: ciascun agente riceve solo il contesto e gli strumenti di cui ha bisogno, e ogni passaggio può essere testato e osservato da solo.
Output tipizzati e validati
Il modello non deve restituire testo libero da interpretare, ma dati strutturati conformi a uno schema. Librerie come Pydantic in Python o Zod in TypeScript definiscono il contratto: campi obbligatori, tipi, formati, valori ammessi. Se l'output non rispetta lo schema viene scartato o rigenerato, e non arriva mai al resto del sistema.
È la stessa disciplina che applichiamo a qualsiasi API esterna: non ci si fida del contenuto finché non è stato validato.
Azioni reversibili, non "transazioni magiche"
Quando un agente agisce su sistemi reali, come scrivere su un database, chiamare un microservizio o inviare dati a un fornitore, bisogna chiedersi cosa succede se un passaggio fallisce a metà.
Tra servizi diversi non esistono garanzie ACID. La soluzione è quella nota dai sistemi distribuiti: transazioni compensative (pattern saga), in cui ogni azione ha un'azione inversa da eseguire in caso di errore, e operazioni idempotenti, che ripetute due volte non producono effetti doppi. Per le azioni irreversibili o ad alto impatto, come pagamenti e comunicazioni ai clienti, la regola è semplice: serve un'approvazione umana.
Sandboxing e minimo privilegio
La prompt injection, cioè istruzioni malevole nascoste in un documento o in una pagina che il modello legge, oggi non si può eliminare del tutto. Si può però limitarne l'impatto:
- il codice e le query generate dal modello vengono eseguiti in ambienti isolati;
- ogni agente ha credenziali con i soli permessi necessari, spesso in sola lettura;
- i contenuti esterni vengono trattati come dati, mai come istruzioni;
- l'accesso agli strumenti passa da interfacce controllate. Standard come il Model Context Protocol (MCP) aiutano a definire in modo esplicito cosa un agente può fare.
Il principio è lo stesso della sicurezza tradizionale: se qualcosa va storto, il danno possibile deve essere piccolo per costruzione.
Osservabilità: sapere sempre cosa è successo
Un sistema che prende decisioni deve poterle spiegare. Per ogni esecuzione registriamo input, passaggi intermedi e decisioni dell'agente, chiamate agli strumenti, risultati della validazione, latenza e costo. OpenTelemetry, con le sue convenzioni per i sistemi di AI generativa, permette di far confluire questi dati negli stessi strumenti di monitoraggio usati per il resto dell'infrastruttura.
A questo si aggiungono le valutazioni automatiche (eval): un insieme di casi reali su cui misurare il sistema prima di ogni modifica al prompt, al modello o agli strumenti. Senza eval, ogni aggiornamento è un salto nel buio.
Dove ha senso usarli
Le architetture multi-agente danno il meglio su processi ripetitivi ma non banali, dove serve "capire" un contenuto prima di agire:
- riconciliazione tra documenti, ordini e movimenti contabili;
- estrazione di dati da PDF, email e formati legacy;
- smistamento e prima lavorazione di richieste e pratiche.
Non sono la soluzione giusta quando un processo è già perfettamente descritto da regole fisse: lì uno script tradizionale è più economico, più veloce e più affidabile.
Come lavoriamo
Quando progettiamo un sistema basato su agenti partiamo dal processo, non dal modello. Mappiamo i passaggi, individuiamo quelli che richiedono davvero comprensione del linguaggio, definiamo gli schemi dei dati e i punti di controllo umano. Solo dopo scegliamo modello e strumenti, e costruiamo il set di valutazioni che ci dice se il sistema è pronto per la produzione.
Vuoi capire se un processo della tua azienda può essere automatizzato con l'AI in modo sicuro? Parliamone.

